

О чем этот курс
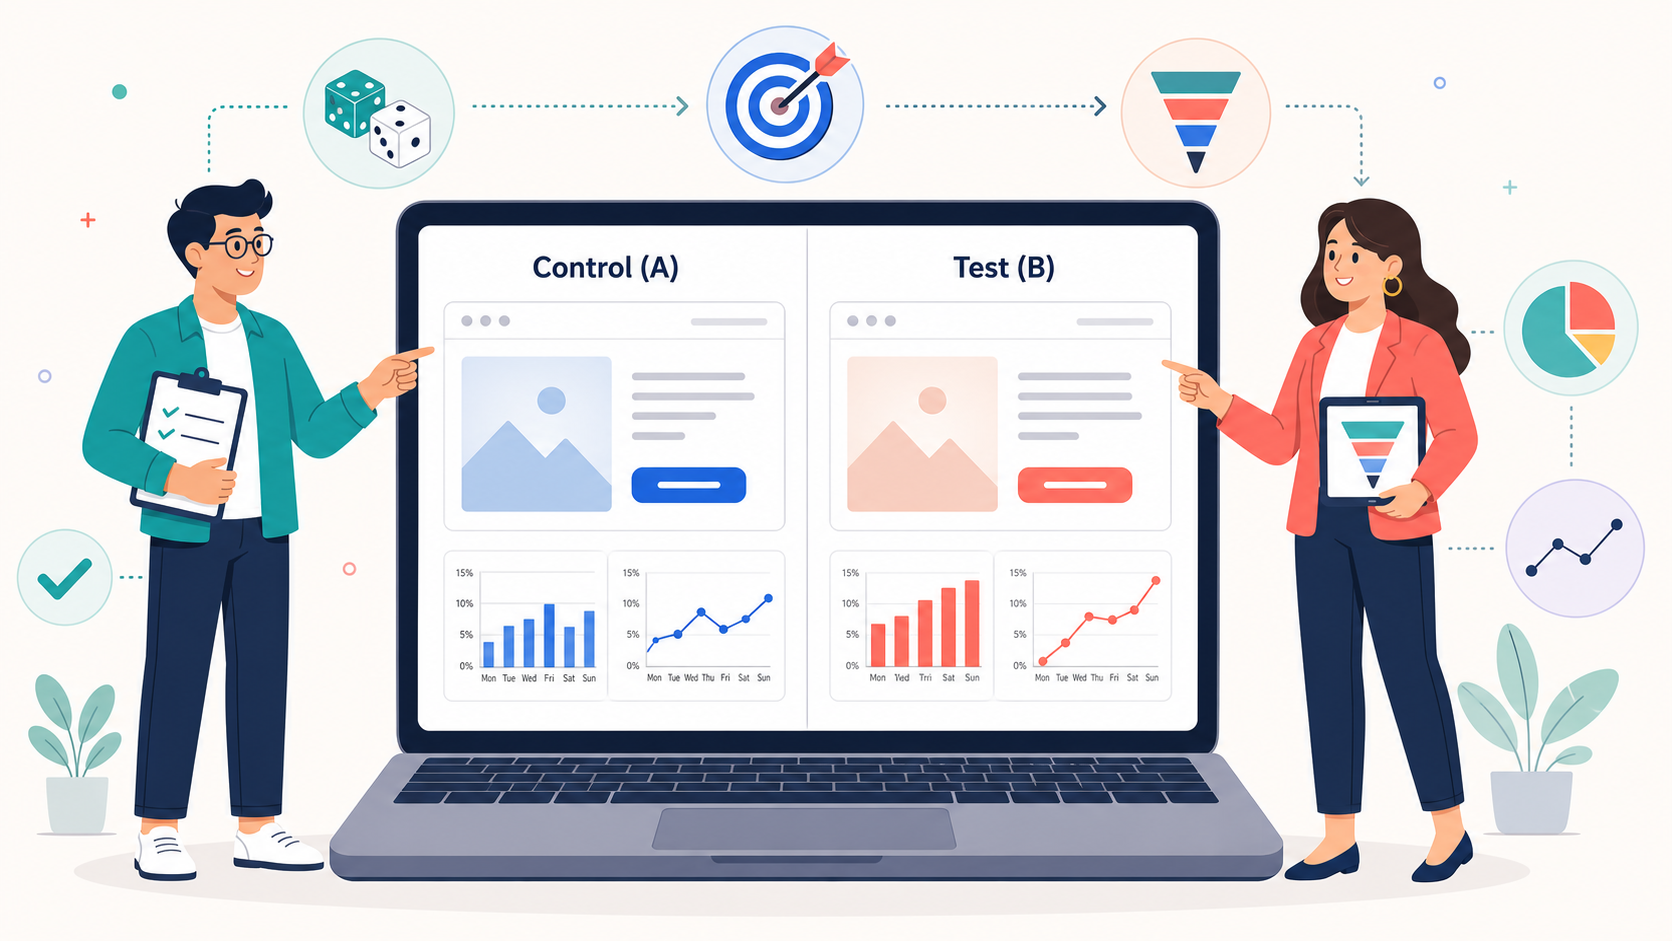
Этот курс — практическое руководство по A/B‑тестам для продакт‑менеджеров, маркетологов и начинающих аналитиков. Вместо сложных формул — понятные шаги, числовые примеры и готовые шаблоны. Вы научитесь отличать настоящий эксперимент от простого сравнения, правильно выбирать метрики, избегать искажений и принимать взвешенные продуктовые решения.
Важно: p‑value не является автоматическим ответом «внедрять/не внедрять». Мы покажем, как сочетать статистическую и практическую значимость, доверительные интервалы, риски и контекст бизнеса.
flowchart TD
    A["Idea"] --> B["Hypothesis"]
    B --> C["Define metrics (primary, guardrails)"]
    C --> D["Design (Control/Test, unit)"]
    D --> E["Randomize"]
    E --> F["Run"]
    F --> G["Monitor guardrails"]
    G --> H["Analyze (effect size, CI, p-value)"]
    H --> I{"Decision"}
    I --|Ship|--> J["Learnings"]
    I --|Repeat|--> J
    I --|Reject|--> J
    J --> K["Backlog"]
Что вы получите
- Шаблон паспорта эксперимента и чек‑лист запуска.
- Интуитивное понимание метрик: основная, защитные, диагностические.
- Навык расчёта примерного размера выборки, длительности и интерпретации интервалов.
- Практику на реальных кейсах, мини‑тесты и разбор типичных ошибок.
Структура и форматы внутри каждого модуля
Каждый модуль включает: кейс, практику с числами, мини‑тест (3–5 вопросов) и разбор ошибочного решения.
Модуль 1. Гипотеза и ожидаемый механизм эффекта
- Смысл гипотезы: «Если мы сделаем X, то Y изменится, потому что Z» — где Z это механизм.
- Кейс: новая кнопка «Купить» на карточке товара.
- Практика: переписать «хотим увеличить конверсию» в проверяемую гипотезу с механизмом.
- Мини‑тест: выбрать корректную формулировку гипотезы и контрафакт.
- Разбор ошибки: гипотеза без механизма → ложное чувство контроля, путаница в метриках.
Модуль 2. Контроль и тест, случайное распределение, единица рандомизации
- Контроль vs тест: что фиксируем, что меняем, что держим постоянным.
- Единица рандомизации: пользователь, сессия, заказ; когда что выбирать (избежать «перетекания» эффектов).
- Кейс: рекомендательная лента — рандомизируем пользователя, а не показ.
- Практика: подобрать единицу рандомизации для 3 сценариев (email‑кампания, баннер, корзина).
- Мини‑тест: определить, где возможны коллизии и как с ними быть.
- Разбор ошибки: рандомизация по сессии при долгоживущем эффекте → смазанные оценки.
Модуль 3. Метрики: основная, защитные и диагностические
- Основная метрика: связка с целью продукта и гипотезой.
- Защитные (guardrails): не ухудшаем отмены, жалобы, ошибки, задержки.
- Диагностические: помогают понять «почему», но не решают «внедрять ли».
- Кейс: рост конверсии в заказ при падении среднего чека — как принять решение?
- Практика: составить дерево метрик и выбрать primary + 2 guardrails.
- Мини‑тест: что делать при конфликте метрик.
- Разбор ошибки: выбор нескольких основных метрик → множественные сравнения и ложные срабатывания.
graph TD
  NSM["North Star Metric"] --> Primary["Primary metric: Conversion"]
  Primary --> CTR["CTR"]
  Primary --> CheckoutRate["CheckoutRate"]
  Primary --> AOV["AOV"]

  subgraph Guardrails
    Retention["Retention"]
    Churn["Churn"]
    Latency["Latency"]
    ErrorRate["ErrorRate"]
  end

  Primary -. "diagnostics" .-> ClickMap["ClickMap"]
  Primary -. "diagnostics" .-> AddToCart["AddToCart"]
  Primary -. "diagnostics" .-> SessionTime["SessionTime"]
Модуль 4. Статистическая и практическая значимость, доверительные интервалы, ошибки I/II рода
- Интуитивно: статистическая значимость говорит «эффект отличим от нуля», практическая — «эффект нам выгоден».
- Доверительный интервал: диапазон разумных значений эффекта.
- Ошибки I/II рода: ложные тревоги и пропущенные улучшения; баланс рисков.
- Кейс: значимость достигнута, но эффект меньше MDE — что решаем?
- Практика: прочитать интервал и сверить с порогом окупаемости.
- Мини‑тест: интерпретация p‑value и 95% CI.
- Разбор ошибки: «p=0.04 значит 96% шанс, что тест лучше» — почему это неверно.
Числовой пример 1: разница конверсий и 95% CI
Эксперимент на посетителях сайта:
| Группа | Посетителей (n) | Покупок | Конверсия |
|---|---|---|---|
| Контроль (A) | 20 000 | 2 000 | 10.0% |
| Тест (B) | 20 000 | 2 140 | 10.7% |
Разница B−A = +0.7 п.п. Пул‑оценка p≈0.1035, стандартная ошибка ≈0.3046 п.п., z≈2.30, p≈0.021. 95% CI: от +0.1 до +1.3 п.п. Вывод: эффект, вероятно, положительный, но нижняя граница может быть меньше порога окупаемости, поэтому бизнес‑решение требует сопоставления с MDE/экономикой.
Модуль 5. Мощность, размер выборки (интуитивно) и длительность теста
- Мощность: шанс заметить важный для нас эффект (MDE) при заданных рисках.
- Правило: меньше базовый уровень и меньше MDE → больше выборка и дольше тест.
- Кейс: email‑кампания с низкой базовой конверсией.
- Практика: прикинуть длительность при данном трафике.
- Мини‑тест: как изменится длительность при MDE в 2 раза меньше.
- Разбор ошибки: остановка «когда стало зелёным» → завышение ложноположительных.
Числовой пример 2: грубая оценка размера выборки и длительности
Цель: увидеть рост с 10.0% до 10.5% (MDE=+0.5 п.п.), α=0.05, мощность 80%.
| Параметр | Значение |
|---|---|
| Оценка n на группу | ≈ 57 000 |
| Доступный трафик/день | 10 000 уникальных пользователей |
| На группу в день | ≈ 5 000 |
| Оценка длительности | ≈ 12 дней чистого трафика → планируем 14 дней, чтобы покрыть полные недели и сезонность |
Модуль 6. Преждевременная остановка и множественные сравнения
- Почему «подглядывание» увеличивает шанс ложноположительного результата.
- Простые стратегии: фиксированный горизонт или корректные последовательные методы.
- Множественные сравнения: много метрик/вариантов → контроль FWER/FDR (на интуитивном уровне). Пример: Бонферрони как простой бампер.
- Кейс: 1 контроль + 4 варианта, 6 метрик — что делать?
- Практика: отметить где нужна корректировка и какие метрики оставить диагностическими.
- Мини‑тест: вопросы на FWER vs FDR.
- Разбор ошибки: выбор лучшего из 5 по наименьшему p‑value без поправок.
Модуль 7. Перекос выборки, сезонность и другие искажения
- Источники перекоса: каналы трафика, устройства, регионы, новые/старые пользователи.
- Сезонность и календарные эффекты: почему важно включать полные недели.
- Коллизии и «перетекание» эффекта между группами; кросс‑девайс.
- Кейс: в тесте больше мобильного трафика — ложный рост конверсии.
- Практика: отчистить срезы и проверить баланс по ключевым признакам.
- Мини‑тест: где риск смещения выше и как его снизить.
- Разбор ошибки: ретроспективное «подсматривание» лучшего среза.
Модуль 8. Анализ результатов и принятие решения
- Чтение отчёта: эффект, 95% CI, p‑value, метрики‑защитники, срезы.
- Решение: внедрять, повторить или отказаться — с учётом практической значимости, рисков и стоимости внедрения.
- Кейс: эффект пограничный, защитная метрика слегка просела.
- Практика: сформулировать рекомендацию и риски.
- Мини‑тест: что делать при конфликте сигналов.
- Разбор ошибки: «p<0.05 значит внедряем всегда» — почему это опасно.
Модуль 9. Итоговый проект
Вы создадите полноценный паспорт эксперимента и отчёт по условным данным, завершив рекомендацией: внедрять, повторить или отказаться.

- Паспорт эксперимента: гипотеза и механизм, аудитория, единица рандомизации, дизайн (контроль/тест), основная и защитные метрики, MDE, размер выборки, длительность, риски и план мониторинга.
- Отчёт по данным: таблицы результатов, 95% CI, интерпретация, влияние на экономику, решение и план дальнейших шагов.
Схема: жизненный цикл A/B‑теста
flowchart TD
    A["Idea"] --> B["Hypothesis"]
    B --> C["Define metrics (primary, guardrails)"]
    C --> D["Design (Control/Test, unit)"]
    D --> E["Randomize"]
    E --> F["Run"]
    F --> G["Monitor guardrails"]
    G --> H["Analyze (effect size, CI, p-value)"]
    H --> I{"Decision"}
    I --|Ship|--> J["Learnings"]
    I --|Repeat|--> J
    I --|Reject|--> J
    J --> K["Backlog"]
Карта метрик
graph TD
  NSM["North Star Metric"] --> Primary["Primary metric: Conversion"]
  Primary --> CTR["CTR"]
  Primary --> CheckoutRate["CheckoutRate"]
  Primary --> AOV["AOV"]

  subgraph Guardrails
    Retention["Retention"]
    Churn["Churn"]
    Latency["Latency"]
    ErrorRate["ErrorRate"]
  end

  Primary -. "diagnostics" .-> ClickMap["ClickMap"]
  Primary -. "diagnostics" .-> AddToCart["AddToCart"]
  Primary -. "diagnostics" .-> SessionTime["SessionTime"]
Оглавление
-
 Гипотеза и механизм эффекта: зачем и как формулировать

-
 Собери гипотезу по шаблону: Что? Для кого? Почему сработает? Чем измерим?
-
 Тест: что является валидной A/B‑гипотезой?
-
 Практика: опишите механизм эффекта для кейса «короче форма регистрации»
-
Ожидаемый эффект в цифрах: простые расчёты в таблицах
-
 Тест: выберите основную и защитные метрики для кейсов
-
 Паспорт гипотезы: заполните шаблон
-
Разбор ошибок: почему «красная кнопка» — не гипотеза
-
Контроль, тест и единица рандомизации
-
Метрики: основная, защитные и диагностические
-
Статзначимость, практическая значимость и доверительные интервалы
-
Мощность, размер выборки и длительность теста
-
Преждевременная остановка и множественные сравнения
-
Искажения: перекос выборки, сезонность, коллизии
-
Анализ результатов и принятие решения
-
Итоговый проект: паспорт эксперимента и отчёт
-
 Сертификат

Похожие курсы
Другие курсы по близким темам